
Ein CDN hat die Aufgabe, dafür zu sorgen, dass die meisten Anfragen den Ursprungsserver nie erreichen. Ein GoldenEye-DDoS-Angriff ist darauf ausgelegt, dass jede einzelne ihn erreicht. Er hängt an jede Anfrage einige zufällig erzeugte Query-String-Parameter an – genug, damit sie für den Cache jedes Mal ein völlig neues Objekt ist. Ein Cache, der eine URL noch nie gesehen hat, hat nichts auszuliefern und fragt beim Ursprungsserver nach.
Damit verschiebt sich, wer hier eigentlich geprüft wird. Der Netzrand nimmt den Datenverkehr weiterhin an und meldet unauffällige Werte, während dahinter Ihre Applikationsserver jede Seite von Grund auf rendern und Ihre Datenbank jede Abfrage beantwortet – mit einer Rate, auf die Sie Ihre Kapazität nie ausgelegt haben, weil Sie mit dem Cache gerechnet haben. Ihr CDN arbeitet genau so, wie es konfiguriert ist. Es ist nur so konfiguriert, dass es den Angriff als sehr viele Besucher liest, die sehr unterschiedliche Inhalte verlangen.
Das Wichtigste in Kürze
- Der Angriff richtet sich gegen Ihren Cache-Key, nicht gegen Ihre Bandbreite. Zwei bis fünf zufällige Parameter pro Anfrage machen aus einem Cache-Hit einen Cache-Miss, und jeder Miss ist ein vollständiger Weg zum Ursprungsserver und zurück.
- Der Schaden entsteht tief im Stack. Ein langsamer Angriff bleibt am Webserver hängen. Dieser hier reicht bis in Ihren Anwendungscode und Ihre Datenbank, denn genau das kostet ein Miss.
- Ob er wirkt, entscheidet die Konfiguration – mit zwei entgegengesetzten Antworten. nginx und Cloudflare nehmen den Query-String standardmässig in den Cache-Key auf; damit ist jede manipulierte URL ein Miss. Die CachingOptimized-Policy von CloudFront nimmt keinen einzigen Parameter auf; dieselben URLs teilen sich dort einen Key.
- Jede Anfrage sieht wie ein Browser aus. Jedes Mal ein anderer, real existierender
User-Agent, bei etwa der Hälfte zusätzlichDNTundUpgrade-Insecure-Requests. Eine Regel, die einen bestimmten schlechten User-Agent sperrt, findet keinen Ansatzpunkt. - Bei der Erkennung ist es umgekehrt. Jede Anfrage landet im Log, an Nachweisen fehlt es also nicht. Benennen lässt sich der Angriff über die Cache-Hit-Rate – und die steht selten auf dem Dashboard.
Dieser Beitrag gehört zu einer Serie über die zehn Simulationstypen, die Obsidio durchführt, einer pro Angriff. Jeder setzt an einer anderen Stelle Ihrer Abwehr an, weshalb ein Testprogramm alle Kategorien abdecken muss und nicht Volumen in einer einzigen. Wie sie zusammenspielen und wie Sie einen ersten Durchlauf aufbauen, steht in unserem Leitfaden dazu, wie Sie Ihren DDoS-Schutz testen.
Die zehn Simulationstypen
Ein Beitrag pro Typ, gruppiert wie auf der Plattform.
Angriffe auf der Anwendungsschicht (L7)
- HTTP-Flood-Angriff
- GoldenEye-AngriffSie sind hier
- Browser-Flood-Angriff
- Apache-Killer-Angriff
Langsame Angriffe
Verbindungserschöpfung
Protokollspezifisch & skriptgesteuert
- DNS-Flood-Angriff
- Puppeteer-Script-Testsfunktionale Last, kein Angriff
Was ein GoldenEye-DDoS-Angriff tatsächlich macht
Die GoldenEye-Simulation von Obsidio ist ein HTTP-GET-Flood aus parallelen Pools, mit einer Ergänzung: Vor jeder Anfrage bekommt die Ziel-URL einen neuen Satz zufälliger Query-String-Parameter. Zwei bis fünf davon, mit Namen, die in einem Logfile ganz gewöhnlich wirken (cb, v, t, nocache und ähnliche), dazu zwei suchtypische Schlüssel wie q, page, ref oder utm_source.
Dazu kommt pro Anfrage eine Header-Schicht. Ist useRandomHeaders aktiv – der Standard –, wird der User-Agent für jede Anfrage aus einem Pool von acht echten Desktop- und Mobile-Browser-Kennungen gezogen. DNT: 1 und Upgrade-Insecure-Requests: 1 kommen bei jeweils rund der Hälfte hinzu, zufällig gestreut, so wie sich eine gemischte Browserpopulation verhält. Ein fester Satz geht bei allen mit: der Host, gewöhnliche Accept-Werte und Cache-Control: no-cache.
Dieser Header leistet weniger, als er verspricht. Eine no-cache-Anfrage ist bloss eine Bitte: RFC 9111 hält fest, dass der Client es vorzieht, eine gespeicherte Antwort nicht ohne erfolgreiche Validierung am Ursprungsserver zur Beantwortung der Anfrage heranzuziehen («indicates that the client prefers a stored response not be used to satisfy the request without successful validation on the origin server»). Ein Cache darf das ablehnen. Beim Query-String liegt der Fall anders, denn RFC 9111 bildet den Cache-Key mindestens aus der Request-Methode und der Ziel-URI – und die URI enthält den Query-String. Ihn zu ändern bittet den Cache nicht, seine Kopie zu übergehen, sondern verlangt eine Ressource, von der er gar keine Kopie hat.
Anders gesagt: ein HTTP-Flood, bei dem jeder Besucher eine andere Verkleidung trägt und beim Eintreten die Bestellnummer leicht abwandelt, damit der Laden nie sagen kann: «Die habe ich schon fertig, hier ist die Kopie.»
Welche Ihrer Schutzmassnahmen das hätte auffangen müssen
Gehen Sie die ganze Kette durch, denn die Antwort liegt selten bei der Massnahme, an die man zuerst denkt. Drei Gruppen zählen: was davor steht, was die durchgekommene Last abbekommt, und ob Ihnen überhaupt jemand Bescheid gibt.
Zone 1
Was fängt sie auf?
- CDN und Cache am Netzrand. Der ganze Angriff zielt hierhin, und eine einzige Einstellung entscheidet den Durchlauf. nginx setzt
proxy_cache_keystandardmässig auf$scheme$proxy_host$request_uri; darin steckt der Query-String, jede manipulierte URL ist damit ein garantierter Miss. Cloudflares Standard-Key enthält den Query-String ebenfalls. Die Managed Policy CachingOptimized von CloudFront enthält keinen; derselbe Verkehr fällt dort auf einen Eintrag zusammen und verlässt den Netzrand nie. Von aussen sieht niemand, welcher Fall bei Ihnen gilt. - DDoS-Schutz und Scrubbing. Diesmal fliesst echtes Volumen, ein Schwellenwert hat also etwas, worauf er anspringen kann. Ob er rechtzeitig anspringt, ist die offene Frage.
- Rate Limiting. Die Schwellenwerte greifen, aber ein Limiter, der die vollständige URL als Schlüssel verwendet, sieht in jeder Anfrage eine andere Ressource.
- Bot-Erkennung und Challenges. Der Wechsel zwischen acht echten Browser-Kennungen entwertet Regeln auf Header-Ebene. Challenges schlagen sich besser.
- Firewall und WAF. Sie sehen wohlgeformte GET-Anfragen ohne bösartigen Inhalt; es gibt also keine Signatur, die passt.
Zone 2
Was bekommt die Last ab?
- Load Balancer oder Reverse Proxy. Cacht er selbst, trennt er nach derselben Key-Logik auf und erbt damit dieselbe Antwort.
- Verbindungsebene. Zu den Anfragen kommt Handshake-Verkehr hinzu, weil standardmässig pro Anfrage ein neuer Socket aufgeht.
- Webserver. Beschäftigt, aber selten der Engpass: Anfragen laufen durch und geben ihren Worker wieder frei.
- Applikation und Datenbank. Hier trifft es. Jeder Miss ist ein vollständiger Rendervorgang: Templates, Sessions, Abfragen. Kapazität, die für Verkehr mit Cache-Unterstützung ausgelegt ist, bedient jetzt alles.
- Auto-Scaling. Es sieht echte Last und skaliert – gewollt und teuer zugleich. Rechnen Sie durch, was eine Stunde davon kostet, bevor Sie es wissen müssen.
Zone 3
Würden Sie davon erfahren?
- Dashboards. Die Anfragen pro Sekunde steigen, in der Kurve ist also etwas zu sehen. Benennen lässt es sich über die Cache-Hit-Rate, und die ist zwei Klicks entfernt.
- Eine Prüfung von ausserhalb Ihres Netzes. Antwortzeiten am Netzrand können ordentlich aussehen, während sich am Ursprungsserver die Anfragen stauen.
- Logging und Ihr SIEM. Alles landet im Access-Log. Die Arbeit ist das Gruppieren: Jeder Treffer bringt einen neuen User-Agent und eine nie gesehene URL.
- Alarmierung. Sie hängt daran, ob überhaupt etwas die Anfragerate am Ursprungsserver oder die Cache-Hit-Rate beobachtet und nicht nur das Volumen am Netzrand.
- Pikettdienst. Gerufen wird jemand, wenn es den Alarm überhaupt gibt. Ob das Runbook einen Flood erwähnt, der den Cache umgeht, liest man besser vorher nach.
Violett markiert, was sich nur mit einem Test auf Ihrer eigenen Infrastruktur klären lässt. Alles andere ergibt sich daraus, wie der Angriff funktioniert, und nicht daraus, wie gut Ihr Team konfiguriert hat.
Die letzte Gruppe fällt Teams erst spät auf. Eine Massnahme, die greift, aber unsichtbar bleibt, ist trotzdem ein Befund.
Was ihn von einem einfachen HTTP-Flood unterscheidet
Ein HTTP-Flood-Angriff und ein GoldenEye-Durchlauf sehen in der Bandbreitenkurve gleich aus und verhalten sich völlig unterschiedlich. Ein HTTP-Flood sendet Methode, URL und Body genau wie konfiguriert, ohne Zufallsanteil; ein Netzrand, der die Ziel-URL cacht, fängt ihn also ab. GoldenEye unterscheidet sich in zwei Punkten, und beide zählen für die Abwehr von DDoS-Angriffen auf Layer 7: Der Cache-Buster macht die Erreichbarkeit des Ursprungsservers zu einer Eigenschaft der einzelnen Anfrage, und die wechselnden Header nehmen Filtern, die auf die Form der Anfrage schauen, die Grundlage. Die Parameter sind schnell erklärt:
parallelRequestsPerWorker, Standard 20, Bereich 1 bis 100. Parallele Schleifen pro Worker. Die Zahl der cache-umgehenden Anfragen pro Sekunde steigt damit annähernd linear; die Plattform rechnet mit fünf pro Sekunde und Schleife, sofern das Ziel innerhalb von 200 ms antwortet.useRandomHeaders, Standard true. Eingeschaltet: ein zufälliger Browser-User-Agentpro Anfrage aus dem Pool von acht. Ausgeschaltet: Alles hängt fest anGoldenEye/1.0und lässt sich mühelos erkennen. Genau darin liegt der Sinn des Schalters – prüfen Sie damit, ob Ihre Header-Regeln überhaupt auslösen.headers, Standard leer. Wird mit dem festen Satz und den Ergänzungen zusammengeführt; was Sie selbst setzen, belegt seinen Platz fest. Wer alsoDNTangibt, ersetzt damit die zufällige Beigabe.
Dazu kommt keepAlive, hier false und bei HTTP Flood true, und dieser Standard lohnt einen zweiten Blick. Ein HTTP-Flood bündelt Sockets, damit sich der Handshake auf viele Anfragen verteilt und die Last auf Applikationsthreads und Datenbank konzentriert. GoldenEye braucht das nicht, denn cache-umgehende URLs erreichen den Ursprungsserver, ob der Socket wiederverwendet wird oder nicht. Das Bündeln bringt nichts, was der Angriff nicht ohnehin schon hätte; also wird der Handshake jedes Mal bezahlt und der Verbindungsaufbau damit Teil der Last. Schalten Sie es ein, bleibt die Erreichbarkeit des Ursprungsservers erhalten, nur belasten Sie den Handshake-Pfad nicht mehr.
Wie Sie sich gegen einen GoldenEye-DDoS-Angriff wehren
Den Cache-Buster können Sie nicht sperren, weil sich Namen nicht aufzählen lassen, die sich jemand erst ausdenkt. Die Arbeit besteht darin, festzulegen, welche Parameter Ihren Cache-Key beeinflussen dürfen, und dafür zu sorgen, dass der Ursprungsserver den Rest aushält.
- Normalisieren Sie den Cache-Key. Bei Cloudflare entfernt die Cache-Stufe «Ignore Query String» den Query-String aus dem Key; verfügbar ist sie in jedem Tarif, auch im kostenlosen. Die Steuerung einzelner Parameter sitzt in den Cache Rules und ist Enterprise. Bei CloudFront ist es eine Frage der Cache-Policy: Die Managed Policy CachingOptimized enthält weder Query-Strings noch Cookies. Bei nginx steht
proxy_cache_keystandardmässig auf$scheme$proxy_host$request_uri; den Query-String loszuwerden heisst, den Key aus$urizu bauen. - Führen Sie eine Positivliste der erlaubten Parameter, statt einzelne zu sperren. Echter Verkehr auf einem Pfad nutzt eine kleine, bekannte Menge, und alles andere auszuschliessen begrenzt die Angriffsfläche. Cloudflare erlaubt in einem eigenen Cache-Key höchstens 100 Parameter. Der Preis ist die Korrektheit: Zwei verschiedene Antworten können sich dann einen Eintrag teilen, was Suche, Seitennavigation und alles Personalisierte unbrauchbar macht. Machen Sie es pro Pfad und aktivieren Sie dazu «Normalize URLs to origin», wie Cloudflare es empfiehlt, um Cache Poisoning zu vermeiden.
- Bot-Management, das nicht an einem Header hängt. Eine Regel auf eine einzelne User-Agent-Zeichenkette scheitert an einem Pool von acht; Challenges und Verhaltenssignale überstehen den Wechsel. Am wichtigsten ist das dort, wo Caching nicht hilft: Cloudflare cacht HTML und JSON standardmässig nicht, ein Flood auf eine dynamische Seite erreicht den Ursprungsserver also unabhängig davon, wie Ihr Key aussieht.
- Begrenzen Sie die Rate am Ursprungsserver nach Identität, nicht nach URL. Die URL ist jedes Mal einmalig; alles, was sie als Schlüssel verwendet, zählt bis eins. Verwenden Sie stattdessen Quelle, Session oder normalisierten Pfad als Schlüssel, und halten Sie den Ursprungsserver direkt unerreichbar – eine offen erreichbare IP-Adresse umgeht jede Massnahme darüber.
Was Sie selbst prüfen können und was dabei falsch herauskommt
Lesen Sie die Cache-Konfiguration und schicken Sie sich dann selbst eine Anfrage mit einem Unsinnsparameter und lesen Sie den Cache-Status, den Ihr CDN zurückmeldet. Billiger kommen Sie an keine brauchbare Antwort: Sie erfahren Pfad für Pfad, wie Ihr Key aussieht. Was Ihr Ursprungsserver tut, wenn dieser Key bei hoher Parallelität aus jeder Anfrage einen Miss macht, erfahren Sie damit nicht.
Prüfen Sie die Alarmierung getrennt davon. Ein synthetischer Alarm bestätigt die Alarmierungskette, ohne dass eine einzige Angriffsanfrage fliesst.
Fahren Sie einen Test aus einer einzigen Quelle gegen die Staging-Umgebung, mit Freigabe aus dem Change Management, auf Infrastruktur, die Ihnen gehört. Legitim, nützlich – und genau dort liegt die Falle.
Ein Test von einer einzigen Maschine lässt die Fragen aus Zone 1 nicht bloss offen. Er beantwortet mehrere davon falsch, und zwar beruhigend falsch. Ihr Rate Limit pro IP-Adresse fängt eine einzelne Quelle in Sekunden ab, die Bot-Erkennung markiert einen Client, der ungewöhnliche URLs abklopft, und die Reputationsfilter sperren die Adresse. Jede Massnahme in der vorderen Zone scheint zu greifen, Sie schreiben «abgewehrt» ins Protokoll – und der Befund, den Sie gebraucht hätten, ist genau der, den Sie nicht bekommen haben.
Dann kommt der echte Angriff von Tausenden IP-Adressen aus Privathaushalten, von denen keine einzige für sich einen Schwellenwert überschreitet, und dieselben Massnahmen verhalten sich anders, weil sie an der Streuung der Quellen und an der Realitätsnähe des Verkehrs ansetzen. Eine einzelne Maschine bildet beides nicht ab, und damit bleibt die Frage unbeantwortet, die über den Vorfall entscheidet: ob Ihr Ursprungsserver hält, wenn die Cache-Hit-Rate auf null fällt.
Wie Obsidio einen cache-umgehenden Flood testet
Obsidio führt GoldenEye als kontrollierte, autorisierte Simulation gegen Infrastruktur durch, die Ihnen gehört. Die Domain-Inhaberschaft wird per DNS-TXT-Eintrag verifiziert, bevor eine einzige Anfrage fliesst; die Last steigt stufenweise an, und jeder Durchlauf lässt sich jederzeit im Betrieb abbrechen. Sie bestimmen die Parallelität pro Worker, ob die Header zufällig gewählt werden und ob Verbindungen wiederverwendet werden. Weil die Last von über 100’000 weltweit verteilten echten Geräten kommt und nicht von einer Handvoll Instanzen im Rechenzentrum, treffen Rate Limits pro IP-Adresse und Reputationsfilter auf dieselbe Streuung der Quellen, die ein echter Angriff hat.
Zwei Messwerte zählen mehr als alle anderen:
- Cache-Hit-Rate. Bricht sie mit dem Start des Durchlaufs ein, greift der Cache-Buster und Ihr Ursprungsserver bedient alles. Bleibt sie stabil, normalisiert Ihr Key die Parameter weg und der Netzrand fängt den Angriff ab – was schwarz auf weiss festzuhalten lohnt.
- Anfragerate am Ursprungsserver. Derselbe Befund, gemessen dort, wo die Last ankommt. Vergleichen Sie sie mit dem, wofür Ihre Applikationsschicht ausgelegt ist, und beobachten Sie daneben die Auslastung des Datenbankpools und die Latenz der Abfragen.
Planen Sie die Fragen zur Erkennung mit ein. Obsidio kann berichten, wie Ihr Netzrand reagiert hat und was dort angekommen ist, weil sich das von aussen messen lässt. Ob Ihre Cache-Analytics den Einbruch gezeigt haben, ob Ihr SIEM etwas korreliert hat und ob jemand gerufen wurde, steht nur in Ihren eigenen Konsolen. Halten Sie also jemanden bereit, der sie während des Zeitfensters beobachtet.
Stärke wird bewiesen, nicht versprochen. Eine hohe Cache-Hit-Rate schützt Sie genau so lange, bis jemand eine URL schickt, die Sie noch nie gesehen haben.
Wo das in ein Testprogramm passt
GoldenEye gehört zu den Floods auf der Anwendungsschicht, neben HTTP Flood, Browser Flood und Apache Killer. Fahren Sie ihn direkt nach einem HTTP-Flood, dann isolieren Sie eine einzige Variable: Wird der HTTP-Flood abgefangen und GoldenEye nicht, liegt der Unterschied in Ihrem Cache-Key. Slowloris dreht hier fast alles um: kein Volumen, das die vordere Abwehr sehen könnte, Schaden, der am Verbindungspool endet, und Stille statt zu viel Lärm. Das ist das Argument dafür, alle zehn Simulationstypen abzudecken statt Volumen in einem einzigen.
Für regulierte Institute muss der Test auch einen Nachweis hinterlassen. Obsidio erzeugt kryptografisch attestierte Berichte, bei denen jede nachträgliche Änderung erkennbar ist, mit Zuordnung zu FINMA, DORA und NIS2 und erstellt in Trusted Execution Environments – am Ende eines Durchlaufs steht damit ein Beleg, den Sie ablegen können, und kein Screenshot, für den Sie bürgen müssen.
Um den Prüfumfang für eine autorisierte GoldenEye-Simulation gegen Ihre eigene Infrastruktur festzulegen, sehen Sie sich die Obsidio-Plattform an oder sprechen Sie mit dem Team. Unabhängig, neutral, überprüfbar: Resilienz, die Sie belegen können.
Ein HTTP-Flood-Angriff enthält nichts Fehlerhaftes. Jede einzelne Anfrage ist vollständiges, gültiges, sauber aufgebautes HTTP – genau der Datenverkehr, den Ihr Server beantworten soll. Einzeln betrachtet lässt sich keine davon von der Anfrage einer Kundin unterscheiden, die ihren Kontostand abruft. In der Summe ergeben sie mehr Arbeit, als Ihr System leisten kann.
Damit ist das die eine Angriffsklasse, in der Ihre vorderste Abwehr überhaupt ein Signal hat, an dem sie ansetzen kann. Das verschiebt die Frage. Sie lautet nicht mehr, ob der DDoS-Schutz den Verkehr sieht, sondern ob der Schwellenwert für die Anfragerate richtig gewählt ist, ob der getroffene Endpunkt cachefähig ist und ob das kleinste Limit in Ihrer Kette dort liegt, wo Sie es vermuten. Das sind alles Fragen der Konfiguration, und Konfigurationen veralten still.
Das Wichtigste in Kürze
- Nichts daran ist ungültig. Die Last entsteht daraus, dass sehr viele Anfragen gleichzeitig in Bearbeitung bleiben. Es gibt keine Signatur, auf die eine Regel passt, und kein fehlerhaftes Feld, das man ablehnen könnte.
- Der Schaden reicht weiter als bei jeder anderen Klasse. Er geht am Webserver vorbei bis zu den Anwendungs-Threads und von dort bis in den Datenbank-Verbindungspool, der meist nur wenige hundert Verbindungen fasst.
- Am Netzrand fällt die Entscheidung. Rate Limiting, Scrubbing und Caching können diesen Angriff stoppen. Ob sie es bei Ihnen tun, hängt von Zahlen in einer Konfigurationsdatei ab.
- Die Verbindungswiederverwendung verändert, was Sie prüfen. Werden Sockets wiederverwendet, konzentriert sich die Last auf die Verarbeitung der Anfragen. Schalten Sie sie ab, wandert ein Teil davon zurück auf den Verbindungsaufbau.
- Die Erkennung scheitert an zu vielen Daten, nicht an zu wenigen. Das Log-Volumen wächst mit dem Anfragevolumen: Ingest-Limits werden erreicht, Ereignisse verworfen, und der Alarm, auf den es ankam, geht als einer von vierhundert ein.
Dieser Beitrag gehört zu einer Serie über die zehn Simulationstypen, die Obsidio durchführt – einer je Angriff. Sie setzen an ganz unterschiedlichen Stellen an, und genau deshalb braucht ein Testprogramm Abdeckung über die Kategorien hinweg statt Masse in einer einzigen. Wie sie zusammenspielen und wie Sie einen ersten Durchlauf aufbauen, steht in unserem Leitfaden dazu, wie Sie Ihren DDoS-Schutz testen.
Die zehn Simulationstypen
Ein Beitrag je Typ, gruppiert wie in der Plattform.
Angriffe auf der Anwendungsschicht (L7)
- HTTP-Flood-AngriffSie sind hier
- GoldenEye-Angriff
- Browser-Flood-Angriff
- Apache-Killer-Angriff
Langsame Angriffe
Verbindungserschöpfung
Protokollspezifisch & skriptgesteuert
- DNS-Flood-Angriff
- Puppeteer-Script-Testsfunktionale Last, kein Angriff
Was ein HTTP-Flood-Angriff tatsächlich tut
Der HTTP-Flood von Obsidio lässt auf jedem Worker mehrere unabhängige Anfrageschleifen laufen. Eine Schleife setzt eine Anfrage ab, wartet auf die Antwort und schickt die nächste in dem Moment los, in dem die Antwort eintrifft. Keine Pause, keine Denkzeit, keine Zufallsstreuung: Methode, URL und Body gehen genau so hinaus, wie sie konfiguriert sind, jedes Mal.
Der Druck entsteht aus der Parallelität, nicht aus der Bandbreite. Zwanzig Schleifen pro Worker, über alle Worker eines Durchlaufs, halten sehr viele Anfragen im selben Augenblick in Bearbeitung, und jede belegt etwas auf Ihrer Seite: einen Platz in der Anfragewarteschlange, einen Anwendungs-Thread, eine Verbindung aus dem Pool, eine Abfrage, die die Datenbank planen und ausführen muss. Ein volumetrischer Angriff füllt Ihre Leitung; dieser hier verbraucht Ihre Kapazität, Arbeit zu leisten.
Stellen Sie sich zwanzig Leute vor, die gleichzeitig an einer Ladentheke stehen und in dem Moment, in dem sie bedient werden, erneut denselben Artikel verlangen. Das Personal kommt nie zur Ruhe.
Dass alle Anfragen identisch sind, hat eine Folge, die man benennen sollte: Ein vorgelagerter Cache darf sie beantworten. Genau das macht den Durchlauf aufschlussreich. Erreicht die immer gleiche Anfrage den Ursprungsserver nie, wissen Sie etwas Belastbares über Ihren Netzrand. Kommt sie jedes Mal durch, haben Sie einen Befund, an dem Sie arbeiten können.
Welche Ihrer Schutzmassnahmen das hätte abfangen müssen
Es lohnt sich, die ganze Kette abzugehen, die eine Anfrage durchläuft, denn die Antwort liegt selten bei der Massnahme, die man erwartet. Drei Gruppen zählen: was der Last vorgelagert ist, was auffängt, was durchkommt, und ob Ihnen überhaupt etwas meldet, dass es passiert ist.
Zone 1
Was fängt sie auf?
- DDoS-Schutz und Scrubbing. Hier liegt ein echtes Signal vor, er sollte also handeln. Ob er es tut, hängt von Schwellenwerten ab, die gegen Ihren normalen Verkehr gesetzt wurden.
- Firewall und WAF. Sie sehen vollständige, gültige Anfragen und finden nichts, worauf eine Regel passt. Sie helfen nur dort, wo sie zusätzlich eine Rate durchsetzen.
- Rate Limiting. Hier fällt die Entscheidung am ehesten. Was als Schlüssel verwendet wird, welche Rate zulässig ist und welcher Burst geduldet wird, macht das ganze Ergebnis aus.
- Bot-Erkennung und Challenges. Statischer Agent-String, kein Browserverhalten – eine Challenge müsste das abfangen. Offen ist, ob der getroffene Endpunkt überhaupt hinter einer steht.
- CDN-Cache. Ein cachefähiger Pfad fängt fast alles davon ab. Ein Login-Formular oder ein API-Aufruf erreicht jedes Mal den Ursprungsserver.
Zone 2
Was bekommt die Last ab?
- Load Balancer oder Reverse Proxy. Er leitet gültige Anfragen weiter, denn das ist seine Aufgabe. Sein Upstream-Pool wird zur ersten Obergrenze.
- Verbindungsschicht. Hält gut stand. Sockets werden normal geöffnet und wieder geschlossen; bei aktivierter Wiederverwendung wickeln wenige Verbindungen viele Anfragen ab.
- Webserver. Worker- und Thread-Pools laufen voll, und sobald sie voll sind, stauen sich neue Anfragen, statt abgewiesen zu werden.
- Anwendung und Datenbank. Hier tut es weh. Anfragen verbrauchen CPU-Zeit, und jede Abfrage nimmt eine Verbindung aus einem Pool, der weit kleiner ist als die Anfragerate.
- Auto-Scaling. Es sieht die Spitze und reagiert, anders als beim langsamen Angriff. Ob es schnell genug reagiert und ob zusätzliche App-Server an einem einzigen Datenbankpool etwas bringen, zeigt der Testlauf.
Zone 3
Würden Sie davon erfahren?
- Dashboards. Die Anfragen pro Sekunde steigen sichtbar an. Das ist der Angriff, den Ihre Kurven gut abbilden.
- Logging und Ihr SIEM. Hier kehrt sich das Problem um: Log-Zeilen vervielfachen sich mit dem Anfragevolumen, Ingest-Limits werden erreicht, Lizenzgrenzen überschritten, Ereignisse fallen dem Sampling zum Opfer – und ausgerechnet das Zeitfenster, das Sie am dringendsten brauchen, fehlt.
- Alarmierung. Irgendetwas löst aus. Ob daraus ein einziger, verwertbarer Alarm wird oder mehrere hundert korrelierte, ist eine Frage der Feinabstimmung, die sich nur unter Last beantworten lässt.
- Pikettdienst. Jemand wird alarmiert, vermutlich mehrfach. Ob der Alarm genug Information für eine Reaktion enthält, zeigt erst der Durchlauf.
- Eine Prüfung von ausserhalb Ihres Netzes. Hier ist sie verlässlich. Sie klärt, ob Nutzer betroffen sind, während intern noch über die Messwerte gestritten wird.
Violett markiert, was nur ein Testlauf an Ihrer eigenen Infrastruktur klären kann. Alles Übrige ergibt sich daraus, wie der Angriff funktioniert, nicht daraus, wie gut Ihr Team konfiguriert hat.
Diese dritte Gruppe entdecken Teams am spätesten. Eine Massnahme, die greift, aber unsichtbar bleibt, ist ebenso ein Befund wie eine, die mehr meldet, als irgendjemand lesen kann.
Die Parameter – und der Kompromiss bei der Verbindungswiederverwendung
Fünf Einstellungen bestimmen den Durchlauf, und jede verlagert die Last an eine andere Stelle:
- Parallele Anfragen pro Worker. Standard 20, einstellbar von 1 bis 100. Ein höherer Wert hebt parallele Last und erreichbare Anfragerate ungefähr linear an. Die Plattform rechnet mit fünf Anfragen pro Sekunde je Schleife, sofern das Ziel innerhalb von 200 ms antwortet.
- Methode. Standard
GET, daneben stehenPOST,PUT,DELETEundHEADzur Verfügung. Einen Body senden nur die Methoden ausserGETundHEAD; eine grosse Nutzlast verschiebt die Kosten also Richtung Upload-Bandbreite und Body-Parsing.HEADnimmt die Kosten für den Antwort-Body auf beiden Seiten heraus. - Nutzlast. Standardmässig leer. Platzhalter wie
{{uuid}}und Zufallstext in wählbarer Länge werden je Anfrage expandiert, sodass sich die Bodys unterscheiden können, während der Anfragepfad gleich bleibt. - Header. Statische Header auf jeder Anfrage. Standardmässig geht nur ein User-Agent mit, der die Simulation kenntlich macht; überschreiben lässt sich alles, und so kommen Auth-Tokens und Cookies hinein.
- Verbindungswiederverwendung. Standardmässig eingeschaltet.
Der letzte Punkt verdient einen eigenen Absatz. Ist die Wiederverwendung eingeschaltet, geht der Socket nach jeder Antwort zurück in den Pool; die nächste Anfrage spart sich den TCP- und den TLS-Handshake, und die Last landet fast vollständig bei der Verarbeitung der Anfragen. Schalten Sie sie ab, öffnet jede Anfrage einen neuen Socket: Die erreichbare Rate sinkt, und ein Teil der Last wandert auf den Verbindungsaufbau – damit prüfen Sie etwas anderes.
Wie lange ein Socket im Pool überlebt, entscheidet Ihr Server und nicht der Client. nginx arbeitet standardmässig mit keepalive_timeout 75s und keepalive_requests 1000: Nach tausend Anfragen oder 75 Sekunden Leerlauf wird die Verbindung geschlossen, ganz gleich, was der Client bevorzugen würde. Wiederverwendung mit einem Server zu kombinieren, der mit Connection: close antwortet, ergibt einen Pool, der nach jeder Antwort abgerissen wird – Overhead auf beiden Seiten.
Wie sich das von GoldenEye und Browser Flood unterscheidet
Alle drei zählen zu den Floods auf der Anwendungsschicht, austauschbar sind sie nicht. GoldenEye hängt zufällige Query-String-Parameter an und wechselt den User-Agent, erreicht damit auch hinter einem CDN den Ursprungsserver und macht header-basierte Filter stumpf. Der HTTP-Flood macht bewusst das Gegenteil: identische Anfragen, damit Ihr Cache seine Arbeit tun darf – und Sie messen können, ob er sie tut. Browser Flood steuert auf jedem Worker einen echten Chromium-Tab und lädt alle Unterressourcen nach, die ein Browser anfordert.
Nehmen Sie den HTTP-Flood für die reine Verarbeitungskapazität, GoldenEye, um den Cache gezielt zu umgehen, und Browser Flood für realistische Nutzerlast.
Wie Sie sich gegen einen HTTP-Flood-Angriff verteidigen
Die Abwehr ist zum grössten Teil eine Rechenaufgabe. Vier Massnahmen leisten den grössten Teil der Arbeit:
- Rate Limiting mit einem Burst, den Sie wirklich gewählt haben. Bei nginx definieren Sie mit
limit_req_zoneSchlüssel und Rate und wenden beides dann dort an, wo Sie es brauchen:limit_req zone=name burst=number. Der Parameterburststeht standardmässig auf 0, oberhalb der Rate wird also nichts geduldet; abgelehnte Anfragen bekommen überlimit_req_statusstandardmässig ein 503. Wählen Sie beide Werte bewusst. - Eine Grenze für gleichzeitige Verbindungen neben der Ratengrenze.
limit_connbegrenzt die gleichzeitigen Verbindungen je Schlüssel und deckt damit eine andere Bruchstelle ab als eine Anfragerate. Auch sie antwortet standardmässig mit einem 503. - Caching, das Sie bestätigt haben. nginx wird mit
proxy_cache offausgeliefert, Caching gibt es also nur dort, wo es jemand eingeschaltet hat;proxy_cache_locksteht ebenfalls standardmässig auf off, gleichzeitige Misses auf denselben Schlüssel gehen also einzeln zum Ursprungsserver. Unter einem Flood werden aus einem kalten Objekt so hunderte Anfragen an den Ursprungsserver. Schalten Sie den Lock ein, fallen sie zu einer einzigen zusammen. - Sie müssen die kleinste Zahl in Ihrer Kette kennen. nginx erlaubt standardmässig
worker_connections 512je Worker-Prozess. ApachesMaxRequestWorkerssteht standardmässig auf 256 bei prefork und auf 400 bei den MPMs event und worker, alsoServerLimit16 malThreadsPerChild25.pm.max_childrenvon PHP-FPM hat gar keinen Standardwert, ist zwingend anzugeben und begrenzt die gleichzeitig bedienten Anfragen.max_connectionsvon PostgreSQL liegt typischerweise bei 100. Ihre tatsächliche Kapazität ist die niedrigste dieser Zahlen – und sehr oft ist das die Datenbank.
Jeder dieser Werte steht in einer Datei, die irgendwann einmal jemand bearbeitet hat – und deshalb ist ein Blick in die Konfiguration ein schwächerer Nachweis als ein Durchlauf.
Was Sie selbst prüfen können – und wo das Ergebnis täuscht
Drei dieser Fragen können Sie heute ohne fremde Hilfe beantworten. Es lohnt sich zu wissen, welche das sind – und an welcher Stelle eine billige Prüfung in die Irre führt.
Lesen Sie die Konfiguration und rechnen Sie nach. Notieren Sie die Ratengrenze und ihren Schlüssel, die gecachten Pfade, die Worker-Obergrenze, den Prozess-Pool, das Verbindungslimit der Datenbank. Die kleinste Zahl ist Ihre Kapazität. Damit kennen Sie die Zahlen. Ob sich die Kette unter Last so verhält, wie die Rechnung nahelegt, wissen Sie damit noch nicht, denn Warteschlangen, Retries und Timeouts greifen auf eine Weise ineinander, die keine Konfigurationsdatei zeigt.
Prüfen Sie den Alarmweg für sich allein. Lösen Sie einen synthetischen Alarm aus und sehen Sie nach, ob er den richtigen Pikettdienst erreicht und ob jemand handelt. Damit prüfen Sie den Meldeweg, und Angriffsverkehr brauchen Sie dafür nicht. Über das Verhalten desselben Meldewegs bei echtem Volumen sagt das nichts.
Führen Sie einen Lasttest aus einer einzigen Quelle gegen eine Staging-Umgebung durch, mit Freigabe aus dem Change-Management, auf Infrastruktur, die Ihnen gehört. Das ist zulässig, und für Kapazitätskurven ist es wirklich nützlich. Genau hier liegt aber auch die Falle.
Eine einzelne Maschine lässt die Fragen der ersten Zone nicht nur offen – sie beantwortet mehrere davon falsch, und zwar beruhigend falsch. Eine Ratengrenze je Quelle fängt einen einzelnen Ursprung sofort ab, die Bot-Erkennung markiert einen einzelnen Client, der sich auffällig verhält, die Reputationsfilterung sortiert ihn aus – und der Netzrand sieht anschliessend tadellos aus.
Ein echter, verteilter Flood tritt anders auf. Tausende Adressen aus Privathaushalten senden jeweils eine unauffällig geringe, plausible Zahl von Anfragen, keine einzelne Quelle überschreitet einen Schwellenwert je Quelle, und die Summe landet trotzdem auf Ihrem Ursprungsserver. Ausgerechnet die Massnahmen, denen Sie am meisten vertrauen müssen, bewertet ein Test aus einer einzigen Quelle zu milde.
Bei der Erkennung zeigt sich dieselbe Schieflage. Ein kleiner Testlauf erzeugt nur wenig Log-Volumen und kann deshalb nicht zeigen, ob Ihr Ingest-Limit erreicht wird, ob Ereignisse verworfen werden oder ob die Person im Pikettdienst den entscheidenden Alarm zwischen den übrigen findet.
Wie Obsidio einen HTTP-Flood prüft
Obsidio führt das als kontrollierte, autorisierte Simulation gegen Infrastruktur durch, die Ihnen gehört. Die Domain-Inhaberschaft wird über einen DNS-TXT-Eintrag geprüft, bevor Verkehr fliesst; die Durchläufe fahren schrittweise hoch, und jeder Durchlauf lässt sich im Betrieb abbrechen. Sie legen Schleifen je Worker, Methode, Nutzlast und Verbindungswiederverwendung fest und beobachten dann Ihr System. Die Last kommt von über 100’000 weltweit verteilten echten Geräten, sodass Limits je Quelle und Reputationsfilterung so geprüft werden, wie ein verteilter Angriff sie prüft.
Drei Punkte, die Sie während des Durchlaufs im Auge behalten sollten:
- Vergleichen Sie die Zählwerte entlang der Kette. Am Netzrand angenommene Anfragen, Anfragen, die den Ursprungsserver erreichen, erfolgreich abgeschlossene Anfragen. Wo diese Zahlen auseinanderlaufen, greift eine Massnahme – und die Differenz sagt mehr als jeder Einzelwert.
- Beobachten Sie den Datenbankpool, nicht die CPU. Die CPU-Last der Anwendung kann noch erträglich aussehen, während Abfragen auf eine freie Verbindung warten. Pool-Auslastung und Warteschlangentiefe zeigen, wo die Obergrenze wirklich liegt.
- Messen Sie von aussen. Serverseitige Messwerte zeigen unter Umständen nur eine massvolle Beeinträchtigung, während eine echte Anfrage von ausserhalb Ihres Netzes längst in den Timeout läuft.
Jede Anfrage läuft durch einen Response-Analyzer; der Bericht hält deshalb für jedes Zeitfenster fest, was am Netzrand geschehen ist: WAF-Antworten, Verhalten des Scrubbings, Ablehnungen durch das Rate Limiting, Captcha-Challenges. Obsidio misst das, weil es von aussen sichtbar ist. Ob Ihr SIEM das Ereignis aufgenommen hat und ob jemand alarmiert wurde, wissen nur Ihre eigenen Konsolen – lassen Sie deshalb während des Zeitfensters jemanden darauf schauen.
Stärke wird bewiesen, nicht versprochen. Ein HTTP-Flood sucht keinen Fehler in Ihrem Code. Er sucht die kleinste Zahl in Ihrem System – und ob sie in letzter Zeit jemand nachgerechnet hat.
Wo das in ein Testprogramm gehört
Ein HTTP-Flood ist fast das genaue Gegenteil von Slowloris. Der langsame Angriff sendet fast nichts, geht an volumenbasierten Abwehrmechanismen vorbei, bleibt am Verbindungspool des Webservers hängen und hinterlässt ausgerechnet in den Dashboards, in die Sie schauen würden, keine Spur. Der Flood dagegen ist laut, liefert Ihren Schutzmassnahmen am Netzrand ein klares Signal, reicht bis in die Datenbank – und begräbt den entscheidenden Befund unter Telemetriedaten. Wer gegen den einen härtet, weiss über den anderen wenig. Ein Programm aus lauter Floods lässt die langsame Klasse ungeprüft; eines aus lauter langsamen Angriffen findet die Kapazitätsgrenze nie.
Für regulierte Institute muss der Testlauf zudem einen Nachweis hinterlassen. Obsidio erzeugt kryptografisch attestierte, manipulationssichere Berichte, die FINMA, DORA und NIS2 zugeordnet sind und in Trusted Execution Environments entstehen – das Ergebnis eines Durchlaufs ist damit ein Beleg für die Akten und kein Screenshot, für dessen Echtheit Sie geradestehen müssen.
Um den Prüfumfang einer autorisierten HTTP-Flood-Simulation gegen Ihre eigene Infrastruktur festzulegen, sehen Sie sich die Obsidio-Plattform an oder nehmen Sie Kontakt mit dem Team auf. Unabhängig, neutral, überprüfbar: Resilienz, die Sie belegen können.
Ein Slowloris-Angriff kann einen Webserver von einem einzelnen Laptop an einem Heimanschluss aus lahmlegen. Er sendet fast keine Daten, erzeugt fast keine Anfragen pro Sekunde und hat mit dem Datenverkehr, gegen den Ihr DDoS-Schutz beschafft wurde, nichts gemein.
Genau darin liegt das Problem. Die meisten Schutzmassnahmen sind auf Volumen ausgelegt: Gigabit pro Sekunde, Anfragen pro Sekunde, Pakete pro Sekunde. Slowloris erreicht sein Ziel gerade dadurch, dass er so wenig wie möglich sendet, so langsam wie möglich und so lange wie möglich. Verwendet Ihr Schutz die Rate als Schlüssel, läuft dieser Angriff daran vorbei, ohne eine Schwelle zu berühren.
Das Wichtigste in Kürze
- Für den Angreifer kostet er fast nichts. Ein erfolgreicher Durchlauf kann von einer einzigen Maschine ein paar Kilobyte pro Sekunde bedeuten – volumenbasierte Schutzmassnahmen haben deshalb nichts, worauf sie anspringen könnten.
- Er wirkt, indem er nie fertig wird. Jede Verbindung sendet einen Teil einer Anfrage und schickt danach nur noch häppchenweise nach; der Server hält die Verbindung höflich offen und wartet auf den Rest.
- Es gibt vier Varianten, und wer sich gegen eine härtet, ist gegen die übrigen nicht geschützt. Ein Timeout für das Lesen der Header stoppt die klassische Version und richtet gegen die Slow-Read-Variante nichts aus.
- Ihr DDoS-Schutz und Ihre WAF entscheiden das vermutlich nicht. Der Ausgang hängt meist an den Timeouts Ihres Webservers und daran, ob Ihr Proxy Anfragen puffert.
- Er bleibt genau dort unsichtbar, wo Sie hinschauen würden. Die Anfragen pro Sekunde wirken normal, und unfertige Anfragen erzeugen oft gar keinen Log-Eintrag.
Dies ist der erste Beitrag einer Serie über die zehn Simulationstypen, die Obsidio durchführt – einer je Angriff. Sie setzen an ganz unterschiedlichen Stellen an, und genau deshalb braucht ein Testprogramm Abdeckung über die Kategorien hinweg statt Masse in einer einzigen. Wie sie zusammenspielen und wie Sie einen ersten Durchlauf aufbauen, steht in unserem Leitfaden dazu, wie Sie Ihren DDoS-Schutz testen.
Die zehn Simulationstypen
Ein Beitrag je Typ, gruppiert wie in der Plattform.
Angriffe auf der Anwendungsschicht (L7)
Langsame Angriffe
- Slowloris-AngriffSie sind hier
- RUDY-Angriff
Verbindungserschöpfung
Protokollspezifisch & skriptgesteuert
- DNS-Flood-Angriff
- Puppeteer-Script-Testsfunktionale Last, kein Angriff
Was ein Slowloris-Angriff tatsächlich tut
Slowloris öffnet viele parallele TCP-Verbindungen zu einem Webserver und weigert sich dann, auch nur eine davon zu Ende zu bringen. Jede Verbindung sendet den Anfang einer HTTP-Anfrage – die Request-Zeile und einen Host-Header – und schickt danach alle paar Sekunden eine weitere Header-Zeile nach. Die abschliessende Leerzeile, die dem Server sagt «die Anfrage ist vollständig, du kannst sie jetzt verarbeiten», trifft nie ein.
Der Server tut das Naheliegende: Er wartet. Er hält die Verbindung offen, hält ihr einen Worker oder einen Platz im Verbindungspool zugewiesen und wartet auf den Rest einer Anfrage, der nie kommt. Rechnen Sie das mal ein paar hundert Verbindungen, und der Pool ist voll. Echte Nutzer bekommen dann einen Timeout und keine Fehlerseite, weil der Server gar nicht erst so weit kommt, sie zu bedienen.
Stellen Sie sich zwanzig Leute vor, die in einem Geschäft anrufen, jeweils eine Bestellung beginnen und dann jeden Satz so in die Länge ziehen, dass das Gespräch nie endet. Das Personal bleibt höflich in der Leitung. Niemand sonst kommt durch.
Neu ist die Technik nicht. Das ursprüngliche Slowloris-Werkzeug erschien am 17. Juni 2009, und es funktioniert bis heute, weil das, was es ausnutzt, kein Fehler ist. Es ist eine Annahme, die tief in der Verbindungsbehandlung von HTTP-Servern steckt: dass ein Client, der zu sprechen begonnen hat, auch vorhat, fertig zu werden.
Welche Ihrer Schutzmassnahmen das hätte abfangen müssen
Es lohnt sich, die ganze Kette abzugehen, die eine Anfrage durchläuft, denn die Antwort liegt selten bei der Massnahme, die man erwartet. Drei Gruppen zählen: was der Last vorgelagert ist, was auffängt, was durchkommt, und ob Ihnen überhaupt etwas meldet, dass es passiert ist.
Zone 1
Was fängt sie auf?
- DDoS-Schutz und Scrubbing. Wartet auf einen Anstieg im Verkehr. Den gibt es nicht.
- Firewall und WAF. Prüft vollständige Anfragen, und diese wird nie vollständig. Sie hilft nur, wenn sie die ganze Anfrage puffert, bevor sie sie nach oben durchreicht – und das tun viele Installationen nicht.
- Rate Limiting. Zählt Anfragen. Dieser Angriff sendet viel zu wenige, um einen Schwellenwert zu überschreiten.
- Bot-Erkennung und Challenges. Es wird nie eine Seite geladen, also gibt es nichts, was sich challengen liesse.
- CDN-Cache. Nichts Cachebares ist im Spiel, er macht also so oder so keinen Unterschied.
Zone 2
Was bekommt die Last ab?
- Load Balancer oder Reverse Proxy. Fängt den ganzen Angriff ab, sofern er Anfragen puffert. Prüfen Sie, ob Ihrer das tut.
- Verbindungsschicht. Füllt sich mit offen gehaltenen Sockets.
- Webserver. Hier tut es weh. Die Worker-Plätze gehen aus, sofern Ihre Timeouts und eine Mindestdatenrate die Verbindungen nicht vorher kappen.
- Anwendung und Datenbank. Werden nie erreicht. Der Angriff endet vorher.
- Auto-Scaling. Sieht keinen Lastanstieg und skaliert deshalb nie.
Zone 3
Würden Sie davon erfahren?
- Dashboards. Die Anfragen pro Sekunde sehen völlig normal aus.
- Eine Prüfung von ausserhalb Ihres Netzes. Das Einzige, was das verlässlich erwischt – sofern Sie eine haben.
- Logging und Ihr SIEM. Unfertige Anfragen erzeugen oft keinen Eintrag im Access-Log; hinterher gibt es dann womöglich nichts zu korrelieren.
- Alarmierung. Nichts überschreitet einen Schwellenwert.
- Pikettdienst. Niemand wird alarmiert. Der Dienst ist ausgefallen, und niemand bemerkt es.
Violett markiert, was nur ein Testlauf an Ihrer eigenen Infrastruktur klären kann. Alles Übrige ergibt sich daraus, wie der Angriff funktioniert, nicht daraus, wie gut Ihr Team konfiguriert hat.
Diese letzte Gruppe entdecken Teams meist spät. Eine Massnahme, die greift, aber unsichtbar bleibt, ist ebenso ein Befund wie eine, die versagt, ohne dass es jemand bemerkt.
Vier Vektoren, vier verschiedene Versagensmuster
«Slowloris» wird oft behandelt, als wäre es ein einziger Angriff. In der Praxis hat das Offenhalten einer Verbindung mehrere eigenständige Formen, und ein Server oder Proxy, der gegen eine gehärtet ist, kann gegen eine andere trotzdem verwundbar sein. Die Slowloris-Simulation von Obsidio führt vier davon aus:
- Slow Header. Der Klassiker. Er sendet
GET /path HTTP/1.1und einenHost-Header, schickt dann je Intervall eine Header-Zeile nach und sendet den Abschluss nie. Der Server bleibt im Zustand «Lese Request-Header» stehen. - Slow POST. Er sendet einen vollständigen, gültigen
POST-Header-Block mitTransfer-Encoding: chunked, schickt dann je Intervall einen Chunk von einem Byte nach und sendet den Chunk der Länge null, der den Body beendet, nie. Die Header sind fertig, ein Timeout für das Lesen der Header greift also nicht. - Slow Read. Er sendet eine vollständige, vollkommen gültige Anfrage und hört dann auf, die Antwort zu lesen. Der Empfangspuffer des Clients füllt sich, der Sendepuffer des Servers staut sich, und die Verbindung lässt sich nicht abbauen. An der Anfrage ist nichts fehlerhaft; der Angriff findet auf der Leseseite statt.
- Slow Drop. Er sendet eine gültige Keep-Alive-Anfrage, bleibt untätig und reisst die Verbindung dann zu einem zufälligen Zeitpunkt abrupt ab. Das bringt reset-artige Fluktuation in die Verbindungstabelle statt gleichmässiger Belegung und belastet damit Verbindungsabbau und Buchführung statt der Kapazität.
Die Unterscheidung zählt, sobald Sie eine Gegenmassnahme konfigurieren. Ein Timeout für das Lesen der Header stoppt Slow Header und richtet gegen Slow Read nichts aus. Ein Timeout für den Body stoppt Slow POST und richtet gegen die beiden anderen nichts aus. Einen Vektor zu prüfen und die Klasse damit für erledigt zu erklären – so werden Teams am Ende überrascht.
Welche Server verwundbar sind
Die Anfälligkeit hängt von der Architektur ab. Server, die je Verbindung einen Thread oder Prozess reservieren, gehen ihnen aus; ereignisgesteuerte Server multiplexen die Verbindungen und verlieren ihre Leistung weit gnädiger.
Apache 1.x und 2.x sind der klassische verwundbare Fall aus der ursprünglichen Offenlegung, dazu dhttpd und der Entwicklungsserver von Flask. Als widerstandsfähig dokumentiert sind nginx, lighttpd, Hiawatha, Cherokee und IIS. «Widerstandsfähige Architektur» ist aber nicht dasselbe wie «sichere Installation»: nginx wird nach wie vor mit den Standard-Timeouts client_header_timeout 60s und client_body_timeout 60s ausgeliefert, also 60 Sekunden freie Belegung je Verbindung, und ein Anwendungsserver hinter dem Proxy hat womöglich überhaupt keinen solchen Schutz.
Prüfen Sie, was in Ihrem System die Verbindung tatsächlich beendet, und nicht, was die Marketing-Seite einer einzelnen Komponente behauptet.
Wie Sie sich gegen einen Slowloris-Angriff schützen
Bei der Abwehr geht es darum, nicht unbegrenzt zu warten, und darum, zu begrenzen, wie viel ein einzelner Client belegen darf. Vier Massnahmen leisten den grössten Teil der Arbeit:
- Timeouts für unvollständige Anfragen. Bei Apache ist
mod_reqtimeoutdie direkte Antwort. Geladen lauten seine StandardwerteRequestReadTimeout handshake=0 header=20-40,MinRate=500 body=20,MinRate=500. Das setzt eine Mindestdatenrate und nicht bloss eine Frist – und erst das würgt ein häppchenweises Senden wirklich ab. Vergewissern Sie sich, dass das Modul geladen ist; verfügbar ist nicht dasselbe wie aktiv. - Mindestdatenrate statt blosser Frist. Eine feste Frist lässt sich aushebeln, indem gerade schnell genug nachgeschickt wird. Eine Untergrenze für die Rate nicht.
- Verbindungslimits je IP-Adresse. Begrenzen Sie die gleichzeitigen Verbindungen je Quelle, damit ein einzelner Client keinen nennenswerten Anteil des Pools belegen kann. Gegen ein Slowloris aus einer einzigen Quelle wirkt das; gegen ein verteiltes deutlich schwächer – und der verteilte Fall ist der, den zu prüfen sich lohnt.
- Ein puffernder Reverse Proxy oder ein CDN. Ein Proxy, der die Anfrage vollständig puffert, bevor er sie weiterleitet, hält die unvollständige Anfrage in seiner eigenen Verbindungstabelle fest und weckt Ihren Ursprungsserver nie. Das ist ein starker Schutz, solange der Ursprungsserver nicht direkt erreichbar ist. Eine über einen Proxy ausgelieferte Website mit offen liegender IP-Adresse des Ursprungsservers ist nicht geschützt.
Jeder dieser Werte steht in irgendeiner Konfigurationsdatei, und damit kann jeder davon falsch sein, veraltet oder von einer späteren Änderung überschrieben, die niemand nachgeprüft hat.
Was Sie selbst prüfen können – und was dabei danebengeht
Drei dieser Fragen können Sie heute ohne fremde Hilfe beantworten. Es lohnt sich zu wissen, welche das sind – und zu wissen, wo eine billige Prüfung Sie in die Irre führt.
Lesen Sie die Konfiguration. Bestätigen Sie, dass das Timeout-Modul geladen ist, sehen Sie sich die tatsächlichen Werte an, prüfen Sie, ob Ihr Proxy puffert. Das sagt Ihnen, dass die Einstellung existiert. Es sagt Ihnen nicht, dass sie hält, wenn viele Verbindungen gleichzeitig offen sind, und das ist eine andere Aussage.
Prüfen Sie den Alarmweg für sich allein. Lösen Sie einen synthetischen Alarm aus und sehen Sie nach, ob er den richtigen Pikettdienst erreicht und ob jemand handelt. Damit prüfen Sie den Meldeweg tatsächlich, und Angriffsverkehr brauchen Sie dafür überhaupt nicht.
Führen Sie einen Test aus einer einzigen Quelle gegen eine Staging-Umgebung durch, mit Freigabe aus dem Change-Management, auf Infrastruktur, die Ihnen gehört. Das ist zulässig und nützlich. Und genau hier liegt die Falle.
Ein Test von einer Maschine lässt die vorigen Fragen nicht nur offen. Er beantwortet mehrere davon falsch, und zwar beruhigend falsch. Ihr Verbindungslimit je IP-Adresse fängt eine einzelne Quelle sofort ab. Die Bot-Erkennung markiert einen einzelnen auffälligen Client. Die Reputationsfilterung sortiert ihn aus. Jede Massnahme der ersten Gruppe scheint zu greifen, und Sie schliessen daraus, dass Sie abgesichert sind.
Dann trifft ein echter verteilter Angriff aus Tausenden von Adressen in Privathaushalten ein, und dieselben Massnahmen verhalten sich völlig anders, weil sie an der Konzentration der Quelle und an der Echtheit des Verkehrs ansetzen – und genau das kann eine einzelne Maschine nicht nachbilden. Die billige Prüfung erzeugt ein falsches Bestanden bei genau den Massnahmen, denen Sie am meisten vertrauen müssen.
Dieselbe Schieflage gilt für die Erkennung. Ein synthetischer Alarm belegt, dass der Meldeweg funktioniert. Er kann Ihnen nicht sagen, ob Ihre Dashboards während eines echten langsamen Angriffs überhaupt etwas zeigen oder ob Ihr Logging ihn erfasst, denn diese Fehler hängen daran, dass der Verkehr echt ist.
Wie Sie prüfen, ob Ihre Slowloris-Abwehr funktioniert
Aus einer Konfigurationsprüfung lässt sich das nicht ableiten. Ob der Pool tatsächlich hält, entscheidet sich im Zusammenspiel von Proxy, Webserver, Anwendungsserver und Verbindungslimits bei echter Parallelität, und dieses Zusammenspiel zeigt keine einzelne Konfigurationsdatei.
Obsidio führt Slowloris als kontrollierte, autorisierte Simulation gegen Infrastruktur durch, die Ihnen gehört. Die Domain-Inhaberschaft wird über einen DNS-TXT-Eintrag geprüft, bevor Verkehr fliesst; die Durchläufe fahren schrittweise hoch, und jeder Durchlauf lässt sich im Betrieb abbrechen. Sie wählen den Vektor, die Zahl der je Worker offen gehaltenen Sockets und das Intervall, in dem nachgeschickt wird, und beobachten dann, was Ihr System tut. Weil die Last von über 100’000 weltweit verteilten echten Geräten kommt und nicht von einer Handvoll Instanzen im Rechenzentrum, wird ein Verbindungslimit je IP-Adresse so geprüft, wie ein tatsächlicher verteilter Angriff es prüfen würde.
Zwei Punkte, die während des Durchlaufs zählen und über die regelmässig gestolpert wird:
- Lassen Sie die Kurve der Anfragerate beiseite. Bei einem langsamen Angriff zählt die Rate geöffnete Verbindungen und nicht Durchsatz. Sie bleibt niedrig, gerade während der Angriff wirkt. Verfolgen Sie stattdessen die gleichzeitig offen gehaltenen Verbindungen und die Spitzenzahl der Verbindungen; das ist die Kennzahl, an der Sie sehen, ob sich der Pool füllt.
- Messen Sie von aussen. Serverseitige Kennzahlen können ruhig aussehen, während echte Nutzer in der Warteschlange in den Timeout laufen. Bestätigen Sie den Effekt mit einer unabhängigen Anfrage von ausserhalb Ihres eigenen Netzes.
Planen Sie auch die Fragen zur Erkennung ein. Obsidio kann berichten, wie Ihre Schutzmassnahmen am Netzrand reagiert haben und wie viele Verbindungen offen gehalten wurden, weil das von aussen sichtbar ist. Ob Ihr SIEM etwas aufgezeichnet hat und ob jemand alarmiert wurde, wissen nur Ihre eigenen Konsolen – lassen Sie deshalb während des Zeitfensters jemanden darauf schauen.
Stärke wird bewiesen, nicht versprochen. Slowloris prüft nicht Ihre Bandbreite. Er prüft, ob seit dem Tag, an dem Ihre Verbindungs-Timeouts gesetzt wurden, überhaupt jemand sie nachgesehen hat.
Wo das in ein Testprogramm gehört
Slowloris gehört zur Kategorie der langsamen Angriffe, neben RUDY, das statt eines Header-Blocks einen Request-Body aushungert. Beide sondieren die Verbindungsbehandlung und die Timeout-Konfiguration. Keinen von beiden deckt ein Flood-Test auf der Anwendungsschicht ab, und deshalb lässt ein Programm, das nur HTTP-Floods durchführt, diese ganze Klasse ungeprüft.
Die zehn Simulationstypen führen an ganz unterschiedlichen Stellen zum Ausfall. Ein HTTP-Flood-Angriff kehrt fast alles Obige um: Die vorgelagerten Schutzmassnahmen haben endlich ein Signal, an dem sie ansetzen können, der Schaden reicht bis in Ihren Datenbank-Verbindungspool, und bei der Erkennung kippt das Problem ins Gegenteil – statt Stille eine Flut von Alarmen. Entscheidend ist die Abdeckung über die Kategorien hinweg, nicht die Masse in einer einzelnen.
Für regulierte Institute muss der Testlauf zudem einen Nachweis hinterlassen. Obsidio erstellt kryptografisch attestierte, manipulationssichere Berichte, die FINMA, DORA und NIS2 zugeordnet sind und in Trusted Execution Environments entstehen – das Ergebnis eines Durchlaufs ist damit ein Beleg für die Akten und kein Screenshot, für dessen Echtheit Sie geradestehen müssen.
Um den Prüfumfang einer autorisierten Slowloris-Simulation gegen Ihre eigene Infrastruktur festzulegen, sehen Sie sich die Obsidio-Plattform an oder nehmen Sie Kontakt mit dem Team auf. Unabhängig, neutral, überprüfbar: Resilienz, die Sie belegen können.
Im November 2025 fing Cloudflare den grössten je öffentlich dokumentierten DDoS-Angriff ab: 31,4 Terabit pro Sekunde, 35 Sekunden lang. Der Datenverkehr stammte nicht aus einem Rechenzentrum, sondern aus einem Botnetz – geschätzt ein bis vier Millionen gekaperte Endgeräte, überwiegend billige Android-TV-Boxen, deren Besitzer nichts davon ahnten.
Darin liegt die entscheidende Eigenschaft eines Botnetzes und der Grund, weshalb es hinter fast jedem grossen DDoS-Angriff steht: Dem Angreifer gehört die Hardware nie. Sie gehört Ihnen – oder Ihren Kunden.
Das Wichtigste in Kürze
- Ein Botnetz ist ein Verbund gekaperter Geräte (Router, Kameras, TV-Boxen, Server), die ohne Wissen ihrer Besitzer mit Schadsoftware infiziert und aus der Ferne gesteuert werden.
- Die Rekrutierung läuft industriell. Schadsoftware wie Mirai durchsucht das Internet nach Geräten mit Werkspasswörtern oder ungepatchten Schwachstellen und übernimmt sie binnen Minuten. Mirai kam 2016 in der Spitze auf rund 600’000 Geräte.
- DDoS ist der wichtigste Einsatzzweck. Ein Botnetz richtet die gebündelte Bandbreite seiner Mitglieder auf ein einzelnes Ziel. Der Rekord vom November 2025 mit 31,4 Tbps kam aus den gekaperten Android-TVs des AISURU-Botnetzes.
- Botnetz-Verkehr lässt sich kaum filtern, weil er von Millionen echter Endgeräte mit legitimen IP-Adressen aus Privathaushalten kommt und nicht von einigen wenigen auffälligen Servern.
- Prüfen lässt sich die eigene Abwehr auch ohne Botnetz. Obsidio erzeugt Verkehr in Botnetz-Grössenordnung mit über 100’000 weltweit verteilten echten Geräten: autorisiert, gesteuert und jederzeit abbrechbar.
Was ist ein Botnetz?
Ein Botnetz ist ein Verbund internetfähiger Geräte, die mit Schadsoftware infiziert und aus der Ferne von einem einzelnen Betreiber gesteuert werden, dem sogenannten Bot-Herder. Jedes infizierte Gerät ist ein «Bot» oder «Zombie». Die Besitzer merken davon so gut wie nie etwas; das Gerät läuft weiter, und die Schadsoftware arbeitet unauffällig im Hintergrund.
Das System besteht aus drei Bausteinen:
- Die Bots. Infrage kommt jedes Gerät mit Prozessor und Netzanschluss: Heimrouter, IP-Kameras, Videorekorder, Smart-TVs, Set-Top-Boxen, Cloud-Server, gelegentlich auch PCs. Das Mirai-Botnetz von 2016 bestand fast ausschliesslich aus Consumer-IoT-Geräten, das AISURU-Botnetz von 2025 aus No-Name-Android-TV-Boxen.
- Der Command-and-Control-Kanal (C2). Darüber erteilt der Betreiber seine Befehle: klassisch über einen zentralen Server, in neueren Architekturen über ein Peer-to-Peer-Netz, das keinen einzelnen Abschaltpunkt mehr bietet.
- Der Betreiber. Immer häufiger ist er nicht dieselbe Person, die das Botnetz einsetzt. Grosse Botnetze werden als «DDoS-for-hire» vermietet; wer den Verkehr auf eine Bank richtet, hat dafür womöglich nur ein Abo für wenige Dutzend Dollar bezahlt.
Wie wird ein Gerät zum Bot?
Ohne jedes Zutun des Besitzers. Die Schadsoftware findet ihre Geräte selbst: Sie durchkämmt das gesamte Internet nach drei Arten von Schwachstellen.
- Werkseitige Standardpasswörter. Die Methode von Mirai und bis heute die ergiebigste. Die Schadsoftware führt eine kurze Liste von Standard-Zugangsdaten mit (
admin/admin,root/12345) und probiert sie an jedem Gerät durch, das sie findet. Allein damit wuchs das Botnetz laut der USENIX-Security-Analyse von 2017 auf einen Spitzenwert von rund 600’000 infizierten Geräten. - Ungepatchte Schwachstellen. Consumer-Geräte bekommen selten Updates. Eine Lücke, die heute in einer Router-Firmware bekannt wird, steht Jahre später auf Millionen Geräten noch offen.
- Manipulierte Software und Lieferketten. Das AISURU-Botnetz bestand zu grossen Teilen aus No-Name-Android-TV-Boxen, die bereits manipuliert ausgeliefert wurden, statt erst beim Nutzer übernommen zu werden.
Jeder neue Bot beginnt sofort selbst mit der Suche nach weiteren Opfern. Deshalb wächst ein Botnetz exponentiell: Mirai infizierte in den ersten 20 Stunden fast 65’000 Geräte und verdoppelte sich anfangs etwa alle 76 Minuten.
Wofür werden Botnetze eingesetzt?
Ein Botnetz bündelt die Ressourcen von Millionen Geräten: Bandbreite, IP-Adressen, Rechenleistung. Die Betreiber nutzen sie selbst oder vermieten sie für:
- DDoS-Angriffe. Der wichtigste Einsatzzweck und das Thema dieses Beitrags. Alle Mitglieder fluten gleichzeitig ein Ziel, bis dessen Kapazität erschöpft ist und legitime Nutzer nicht mehr durchkommen.
- Credential Stuffing. Geleakte Zugangsdaten werden an Login-Seiten durchprobiert, verteilt über Tausende IP-Adressen, sodass kein Rate Limiting anschlägt.
- Spam- und Phishing-Versand. IP-Adressen aus Privathaushalten passieren Reputationsfilter, an denen Rechenzentrums-IPs scheitern.
- Residential-Proxy-Netze. Die IP-Adressen der Bots werden an jeden vermietet, dessen Verkehr aussehen soll, als käme er aus einem Privathaushalt.
- Kryptomining. Gestohlener Strom und gestohlene Rechenleistung, in grossem Stil.
Warum lässt sich Botnetz-Verkehr so schwer filtern?
Weil jede einzelne Anfrage für sich genommen legitim aussieht. Genau daran scheitert eine Abwehr, die auf offensichtliche Merkmale ausgelegt ist:
- Echte Geräte, echte IP-Adressen. Der Verkehr stammt von echter Consumer-Hardware an privaten Anschlüssen, aus demselben Adressraum wie der Ihrer Kunden. Wer nach IP-Reputation sperrt, sperrt auch Kunden aus.
- Verteilung. Eine Million Quellen mit je einer Anfrage hebeln jedes Rate Limiting pro IP aus. Keine einzelne Quelle überschreitet je einen Schwellenwert.
- Echte Browser, echtes Verhalten. Moderne Botnetze auf Android-Hardware starten echte Browser-Engines, führen JavaScript aus und bestehen gängige Bot-Erkennung. Unser Beitrag zum Browser Flood geht auf dieses Szenario im Detail ein.
- Geografische Streuung. Der Verkehr trifft aus allen Regionen gleichzeitig ein. Geo-Blocking sperrt Märkte aus, nicht den Angriff.
Für Verteidiger folgt daraus eine unbequeme Einsicht: Ein Filter, der auf «offensichtlich gefälschten» Verkehr geeicht ist, lässt das meiste durch, was ein modernes Botnetz sendet.
Von Mirai bis AISURU: Wie gross werden Botnetze?
Drei Datenpunkte, jeder zu seiner Zeit ein öffentlicher Rekord, zeigen die Entwicklung:
- September 2016: Mirai gegen KrebsOnSecurity. Über 600 Gbps gegen die Website eines einzelnen Journalisten, aus rund 600’000 infizierten IoT-Geräten (Antonakakis et al., USENIX Security 2017).
- 21. Oktober 2016: Mirai gegen Dyn. Dasselbe Botnetz, diesmal gegen einen DNS-Anbieter gerichtet, nahm Twitter, Netflix, Spotify und Amazon für weite Teile der USA und Europas vom Netz. Angegriffen wurden die Resolver eines einzigen Unternehmens; zu spüren bekam es das halbe Internet.
- November 2025: AISURU gegen Cloudflare-Kunden. 31,4 Tbps, rund das Fünfzigfache des Krebs-Angriffs, aus geschätzt ein bis vier Millionen Geräten, gefolgt von einer HTTP-Kampagne mit über 200 Millionen Anfragen pro Sekunde (Cloudflare DDoS Threat Report, Q3 2025).
Und das Tempo nimmt zu. Allein in den dreizehn Monaten bis November 2025 fiel der öffentliche Rekord vier Mal:
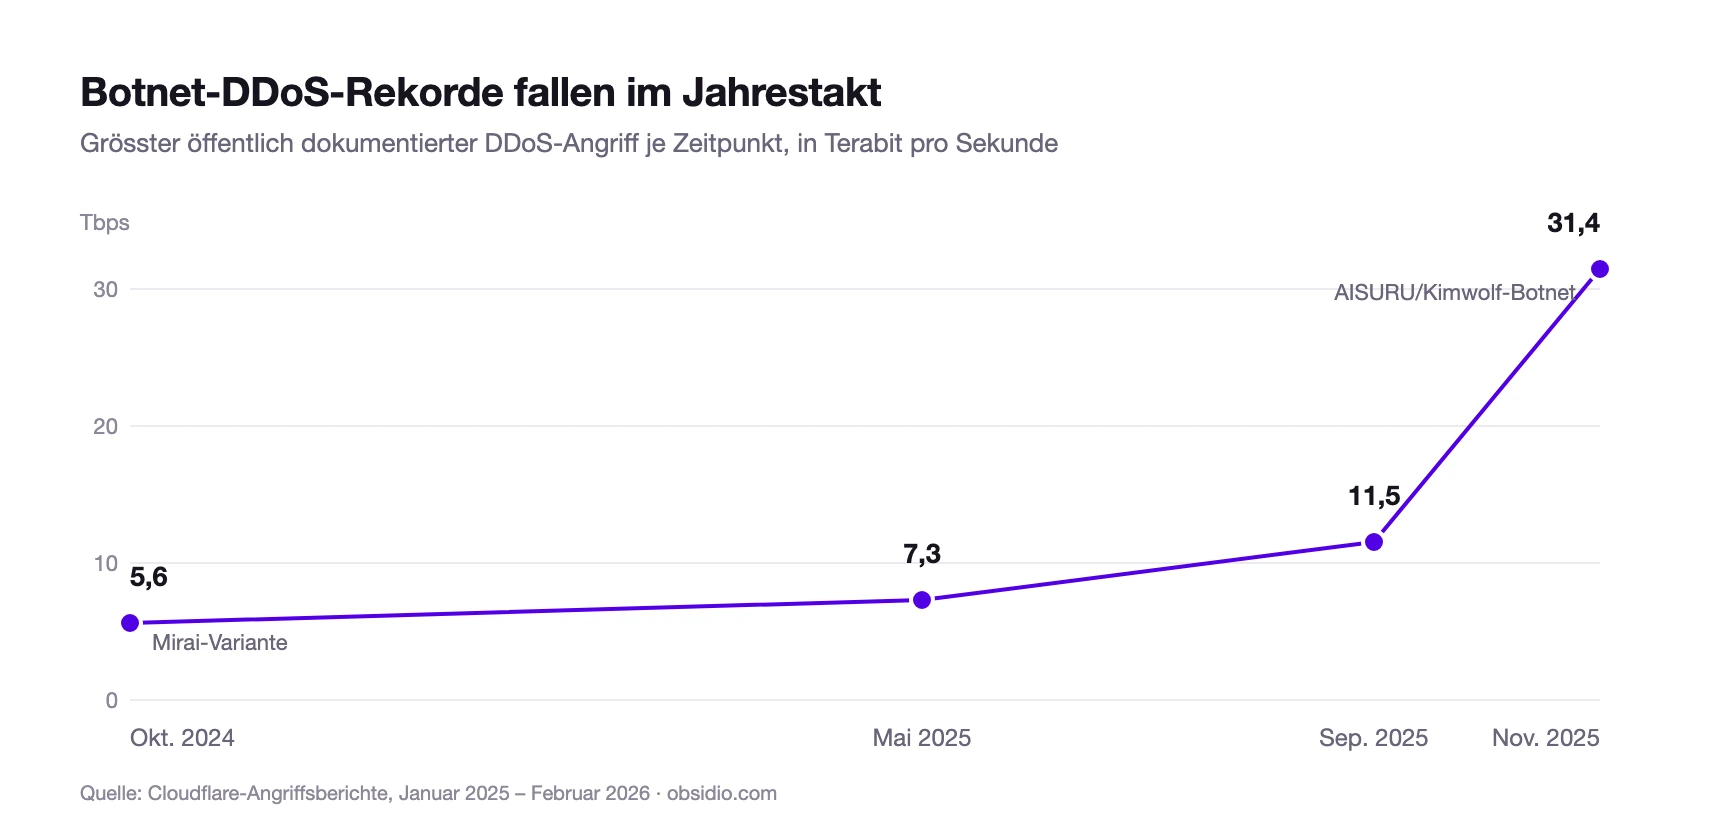
Die Ursache ist schlicht: Jedes Jahr kommen Milliarden billiger, ungepatchter, vernetzter Geräte ans Netz, und jedes einzelne davon ist ein potenzieller Bot.
Was bedeuten Botnetze für regulierte Institute?
Für eine Bank, einen Versicherer oder eine Finanzmarktinfrastruktur wird aus der Bedrohung eine konkrete aufsichtsrechtliche Erwartung: der Nachweis, dass die eigenen Dienste unter genau dieser Last erreichbar bleiben.
- DORA (Verordnung (EU) 2022/2554) verlangt mindestens jährliche Tests der digitalen operationalen Resilienz für IKT-Systeme, die kritische Funktionen stützen (Artikel 24); szenariobasierte Tests zählen zu den aufgeführten Methoden (Artikel 25).
- Die FINMA erwartet von Schweizer Instituten, operationelle Risiken für kritische Dienste zu steuern, Cyber-Szenarien eingeschlossen, gemäss Rundschreiben 2023/1.
- NIS2 (Richtlinie (EU) 2022/2555) verpflichtet wesentliche und wichtige Einrichtungen zu Massnahmen, die die Kontinuität ihrer Dienste sicherstellen, darunter die Widerstandsfähigkeit gegen Angriffe (Artikel 21).
Keines dieser Regelwerke lässt «wir haben einen Vertrag über DDoS-Schutz» als Nachweis gelten. Gefragt ist, ob die Abwehr funktioniert – und das zeigt sich erst unter realistischem Druck.
Wie prüft man gegen Verkehr in Botnetz-Grössenordnung, ohne Botnetz?
Für genau dieses Problem wurde Obsidio entwickelt. Ein aussagekräftiger Test muss die Eigenschaften reproduzieren, die Botnetz-Verkehr gefährlich machen – echte Geräte, private Anschlüsse, globale Verteilung, echtes Browser-Verhalten –, ohne je ein gekapertes Gerät anzufassen.
Obsidio führt DDoS-Simulationen über 100’000 weltweit verteilte echte Geräte durch: Hardware, deren Besitzer ihre Kapazität rechtmässig und mit ausdrücklicher Zustimmung zur Verfügung stellen, orchestriert in Trusted Execution Environments mit lückenlosem Audit-Logging. Der Verkehr ist von einem echten Botnetz-Angriff nicht zu unterscheiden, weil er dieselbe Form hat. Jede Simulation verlangt aber einen ausdrücklichen Nachweis der Domain-Inhaberschaft für das Ziel, bleibt in Ihrer Hand, wird schrittweise hochgefahren und lässt sich anhand von Live-Metriken jederzeit sofort abbrechen.
Kurz: der Realismus eines Botnetzes, dazu die Autorisierung, die Steuerbarkeit und die Nachweise, die ein Compliance-Team braucht. Jeder Durchlauf erzeugt einen kryptografisch attestierten Bericht, der sich den Erwartungen von FINMA, DORA und NIS2 zuordnen lässt.
Wenn Sie wissen wollen, wie sich Ihre Abwehr verhält, sobald eine Million harmlos aussehender Anfragen gleichzeitig eintrifft: Der Einstieg ist unser Leitfaden DDoS-Schutz testen. Oder sprechen Sie mit unserem Team über eine kontrollierte Simulation gegen Ihre eigene Infrastruktur.
Die meisten Teams lernen die Grenzen ihres DDoS-Schutzes im Ernstfall kennen. Das ist der denkbar schlechteste Zeitpunkt, um festzustellen, dass eine WAF-Regel zu locker gefasst war oder ein Ursprungsserver nie abgeschirmt wurde. Wer seinen DDoS-Schutz vorher prüft, steht am Ende mit einem kontrollierten Befund da und nicht mit einem öffentlichen Ausfall.
Dieser Leitfaden richtet sich an diejenigen, die dieses Risiko in einem regulierten Institut verantworten: Security-Engineers, Betreiber von WAF und Load Balancern sowie Compliance-Verantwortliche, die Resilienz gegenüber der Aufsicht belegen müssen. Er beschreibt, was ein sauberer Testlauf misst, wie Sie ihn durchführen, ohne den eigenen Dienst lahmzulegen, und wie aus dem Ergebnis ein prüffähiger Nachweis wird.
Was ein Test des DDoS-Schutzes tatsächlich leistet
Ein DDoS-Test schickt kontrollierten, realistischen Angriffsverkehr auf Infrastruktur, die Ihnen gehört, und misst, ob Ihre Abwehr ihn auffängt und wie sich der Dienst unter Last verhält. Es geht nicht darum, die Website lahmzulegen, sondern darum, die Bruchstelle zu finden, an der der Schutz nachgibt – damit Sie sie nach Ihrem eigenen Zeitplan beheben können.
Zwei Abgrenzungen gehören dazu:
- Ein DDoS-Test ist kein Booter und kein Stresser. Solche Dienste feuern anonymen Datenverkehr auf beliebige Ziele. Sie sind illegal, sobald sie auf etwas gerichtet werden, das Ihnen nicht gehört, und sie liefern weder eine Messung noch einen Autorisierungsnachweis noch einen Bericht.
- Er ist auch kein gewöhnlicher Lasttest. Ein Lasttest fragt: «Können wir 10’000 legitime Nutzer bedienen?» Ein DDoS-Test fragt: «Was passiert, wenn der Verkehr bösartig oder fehlerhaft ist oder gezielt darauf ausgelegt, eine Ressource zu erschöpfen, die unser Lasttest nie berührt?» Anderer Verkehr, andere Fehlerbilder.
Der Nutzen liegt in der Genauigkeit. Ein guter Testlauf sagt Ihnen, welche Schicht nachgegeben hat, bei welchem Volumen und ob Ihre Mitigation rechtzeitig ausgelöst hat.
Die Autorisierung steht vor dem ersten Paket
Was legitimes Resilienztesting von einem Angriff trennt, ist die Autorisierung. Geprüft wird ausschliesslich, was Ihnen gehört oder wozu Sie ausdrücklich beauftragt sind, und die Inhaberschaft wird nachgewiesen, bevor das erste Paket fliesst.
Obsidio erzwingt das über einen DNS-TXT-Eintrag als Nachweis der Domain-Inhaberschaft. Sie hinterlegen den Eintrag auf der Domain, die Sie prüfen wollen; solange er nicht bestätigt ist, startet keine Simulation. Jeder Durchlauf ist kontrolliert, wird schrittweise hochgefahren und lässt sich im Betrieb abbrechen. Das macht die Übung für eine Rechtsabteilung vertretbar und für eine Compliance-Akte wiederholbar: Die Autorisierung ist dokumentiert und nicht bloss vorausgesetzt.
Behandeln Sie das als die erste Schutzmassnahme, die auf dem Prüfstand steht, nicht als Formalie. Wenn Ihr eigenes Change-Management für einen Test keine unterzeichnete, zeitlich befristete Autorisierung hervorbringt, wird es das im Ernstfall ebenso wenig tun.
Die Angriffstypen, gegen die sich ein Test lohnt
DDoS ist keine einzelne Angriffsform, und ein Schutz, der eine Klasse abwehrt, kann für die nächste blind sein. Ein Testprogramm sollte die verschiedenen Arten durchspielen, auf die ein Dienst ausfällt. Der Simulationskatalog von Obsidio verteilt sich auf vier Kategorien, die jeweils einen anderen Teil Ihres Stacks belasten:
- Angriffe auf der Anwendungsschicht (Layer 7). Der HTTP-Flood treibt grosse Mengen wohlgeformter Anfragen gegen den Anwendungspfad: die Request-Queue, die Anwendungs-Threads und die Datenbank dahinter. GoldenEye hängt jeder Anfrage einen zufälligen Query-String an, sodass sie am Cache vorbeigeht und den Ursprungsserver erreicht, dazu wechselnde, browserähnliche Header. Der Browser Flood arbeitet mit echten Browser-Sitzungen, die die ganze Seite samt allen Unterressourcen laden und dabei Verkehr erzeugen, der sich kaum von dem echter Nutzer trennen lässt. Apache Killer schickt überlappende Range-Header (CVE-2011-3192), die einen verwundbaren Apache-Build zwingen, den Inhalt der Antwort vielfach im Arbeitsspeicher vorzuhalten – Anfragen mit geringer Rate, die einen ungepatchten Server erschöpfen können.
- Langsame Angriffe. Slowloris hält viele Verbindungen offen, indem er unvollständige Anfragen häppchenweise nachschickt, und erschöpft so den Verbindungspool bei nahezu null Bandbreite. RUDY öffnet langsame POST-Anfragen, kündigt eine korrekte Content-Length an und sendet den Body dann Byte für Byte; das bindet die Worker, die die Anfrage bearbeiten. Beide setzen am Verbindungs-Handling und an den Timeout-Einstellungen an – ein verbreiteter blinder Fleck bei Schutzmassnahmen, die auf Volumen ausgelegt sind.
- Verbindungserschöpfung. Der TLS-Flood führt den vollständigen TLS-Handshake durch, bürdet dem Server damit die Rechenkosten der asymmetrischen Kryptografie auf und kappt die Verbindung anschliessend. Der TCP Connection Flood öffnet reine TCP-Verbindungen und hält sie im Leerlauf, bis Verbindungstabelle, Dateideskriptoren und Accept-Queue erschöpft sind. Damit geraten Kapazitätsgrenzen in den Blick, die eine ratenbasierte Abwehr nie zu sehen bekommt.
- Protokollspezifisch und skriptgesteuert. Der DNS-Flood sendet reine DNS-Anfragen über TCP, eine Verbindung je Anfrage, und belastet damit die CPU des Resolvers und die Ressourcen des TCP-Listeners. Puppeteer Script fährt einen skriptgesteuerten Ablauf in echten Browsern – Login, Formularabsendung, ein durchgehender Prozess – mit hoher Parallelität; dabei geht es um funktionale und synthetische Nutzerlast, nicht um die blosse Anfragerate.
Der Katalog wächst mit den Techniken der Angreifer. Decken Sie schon beim ersten Test mehrere Kategorien ab: mindestens einen Flood auf Anwendungsebene und einen langsamen oder verbindungserschöpfenden Angriff, weil sie an unterschiedlichen Stellen Ihres Stacks zum Ausfall führen.
Eine wiederholbare Methode: konfigurieren, testen, anpassen, erneut testen
Ein einzelner Test ist eine Momentaufnahme; Resilienz zeigt sich erst in der Wiederholung. Obsidio gliedert jeden Durchlauf in vier Phasen:
- Autorisieren. Die Domain-Inhaberschaft per DNS-TXT-Eintrag nachweisen, bevor irgendetwas läuft.
- Konfigurieren. Simulationstyp, Prüfumfang, geografische Verteilung und Dauer festlegen. Fangen Sie klein an: Ein Durchlauf mit geringer Intensität bestätigt, dass Ihr Monitoring und Ihr Abbruchpfad funktionieren, bevor Sie das Volumen erhöhen.
- Simulieren. Den kontrollierten Test aus der verteilten Geräteflotte fahren und dabei die Live-Metriken verfolgen: Anfragen pro Sekunde, Erfolgsquote und übertragene Datenmenge.
- Berichten. Das Ergebnis als attestierten Nachweis dessen exportieren, was tatsächlich passiert ist.
Dann wird angepasst: eine WAF-Regel justieren, ein Rate Limit nachziehen, ein Timeout erhöhen – und erneut testen, um zu belegen, dass die Korrektur greift. Den zweiten Durchlauf lassen Teams gern aus, und gerade er zählt am meisten. Eine Korrektur, die nie unter Last geprüft wurde, ist eine Hypothese und keine Schutzmassnahme.
Was realistischer Verkehr voraussetzt
Ein Test ist nur so aussagekräftig wie der Verkehr, der ihn erzeugt. Eine Abwehr, die sich an offensichtlichen Merkmalen orientiert – einem einzelnen Quell-Subnetz, einem festen User-Agent, IP-Bereichen von Rechenzentren –, «besteht» jeden Test, der dieselben Merkmale mitbringt, und versagt dann gegen ein echtes Botnetz, das sie nicht mitbringt.
Obsidio erzeugt die Last aus über 100’000 weltweit verteilten echten Geräten statt aus virtualisierten Instanzen; deren Besitzer stellen ihre Kapazität rechtmässig und mit ausdrücklicher Zustimmung zur Verfügung. Der Verkehr kommt von echter Hardware und von Smartphones, über viele Netze und Regionen hinweg. Sie prüfen Ihre Abwehr damit gegen etwas, das einem echten verteilten Angriff gleicht, und nicht gegen ein Laborkonstrukt, das Ihre WAF mühelos herausfiltert.
Aus einem Test einen Compliance-Nachweis machen
Für ein reguliertes Institut ist ein bestandener Test, der keine Spur hinterlässt, wenig wert. Die Regelwerke verlangen inzwischen den Nachweis und nicht nur das Bemühen.
Nach dem Digital Operational Resilience Act (DORA) der EU müssen Finanzunternehmen ein Programm für digitale operationale Resilienz unterhalten und mindestens jährlich angemessene Tests der IKT-Systeme durchführen, die kritische oder wichtige Funktionen unterstützen (Artikel 24). Bedeutende Institute müssen zusätzlich mindestens alle drei Jahre erweiterte bedrohungsorientierte Penetrationstests (TLPT) durchlaufen (Artikel 26). NIS2 verpflichtet wesentliche und wichtige Einrichtungen, Risikomanagementmassnahmen zu ergreifen und sie zu prüfen, und die FINMA erwartet von Schweizer Instituten, operationelle Resilienz auf vergleichbarer Grundlage zu steuern.
Gemeinsam ist diesen Regelwerken die Forderung nach belegbarem, wiederholbarem Testen – nach der Art von Prüfbestätigung, die Sie einem Prüfer oder dem Verwaltungsrat vorlegen können. Obsidio erzeugt kryptografisch attestierte, manipulationssichere Berichte, die FINMA, DORA und NIS2 zugeordnet sind und innerhalb von Trusted Execution Environments entstehen, sodass sich das Ergebnis nachträglich nicht stillschweigend ändern lässt. So wird aus dem Ergebnis eines Tests der Beleg in Ihrer Compliance-Akte.
Stärke wird belegt, nicht versprochen. Ein Test, den Sie attestieren können, macht aus der Behauptung «Wir sind resilient» eine Aussage, die ein Prüfer nachvollziehen kann.
Womit Sie anfangen
Wenn Sie Ihren DDoS-Schutz noch nie geprüft haben, beginnen Sie mit einem einzelnen autorisierten Durchlauf geringer Intensität auf Anwendungsebene, gegen eine Staging-Umgebung oder in einem geplanten Zeitfenster. Beobachten Sie, wie Monitoring und Mitigation reagieren, und weiten Sie den Prüfumfang von dort aus. Der erste Test geht selten ohne Befund aus – genau deshalb führen Sie ihn durch, bevor es ein Angreifer tut.
Wenn Sie eine kontrollierte Simulation gegen Ihre eigene Infrastruktur planen wollen, nehmen Sie Kontakt mit dem Obsidio-Team auf oder fordern Sie eine Demo an. Unabhängig, neutral, überprüfbar: Resilienz, die Sie belegen können.